Qué son los datos estructurados y para qué sirven en tu web
Google lee tu web como alguien que lee una carta en un idioma que no domina del todo. Reconoce palabras, intuye el sentido y de vez en cuando se equivoca.
Qué son los datos estructurados y para qué sirven en tu web
Google lee el texto de tu web, pero a menudo tiene que adivinar qué es cada cosa. «Nansa Digital, Sabadell, diseño web» puede ser una empresa, una cita dentro de un artículo o la recomendación de otra persona. Una persona lo entiende por el contexto. Un buscador lo deduce, y a veces se equivoca.
Los datos estructurados sirven para que no tenga que deducirlo.
¿Qué son los datos estructurados (schema)?
Son información añadida al código de la web que dice de forma explícita qué es cada contenido: una empresa, una persona, un servicio, un artículo o un lugar.
El visitante no los ve. Los buscadores y otros sistemas que leen webs, sí. El vocabulario más extendido es Schema.org, impulsado por los principales buscadores, y el formato habitual es JSON-LD, un bloque de código que no toca el diseño de la página:
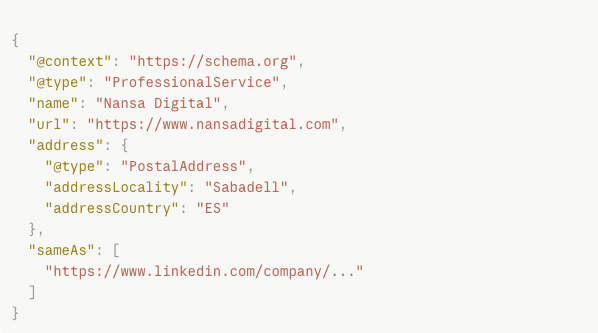
Leído en voz alta dice: Nansa Digital es un servicio profesional, tiene este dominio, está en Sabadell y este perfil de LinkedIn también es suyo. Ninguna línea deja margen a la interpretación.
El texto de la web convence a personas. El schema se lo deja claro a las máquinas.
¿Por qué los necesita una pyme?
Porque una pyme tiene poca información sobre sí misma en internet, y la poca que tiene conviene que sea inequívoca.
Una marca grande tiene artículos, directorios y miles de menciones que la definen. Una asesoría del Vallès tiene una web, una ficha de Google y cuatro menciones en asociaciones. Si la web explica bien la especialidad y el código identifica la empresa y los servicios, Google recibe la información hecha en lugar de tener que reconstruirla.
El schema hace que lo que ya tienes se lea sin errores. La falta de contenido o de reputación se arregla por otras vías. Además, algunas páginas pueden optar a resultados enriquecidos de Google si cumplen los requisitos de cada tipo.
¿Cómo ayudan los datos estructurados a definir la entidad digital de una empresa?
Declarando desde el código relaciones que Google, si no, tendría que deducir: qué perfiles son tuyos, quién fundó la empresa y quién presta cada servicio.
En Qué es la entidad digital de tu empresa explicamos que la idea que Google y la IA se hacen de tu negocio sale de muchas piezas: la web, la ficha de Google, las redes, las reseñas, las asociaciones. El schema es la manera de juntar unas cuantas tú mismo. Tres propiedades hacen ese trabajo:
• sameAs enumera los perfiles que representan a la misma empresa: el LinkedIn corporativo, el Instagram oficial, la ficha en el colegio profesional.
• founder identifica quién fundó la organización. Si el responsable actual es otra persona, esta propiedad no le corresponde.
• provider indica quién presta un servicio descrito con Service.
Google puede contrastar estas declaraciones con otras fuentes, o ignorarlas. Pero ya no depende de nombres parecidos y textos dispersos para relacionarlo todo.
¿Qué tipos de schema necesita una web de empresa?
Los que describen lo que realmente hay en cada página, que normalmente son la organización, los servicios, las personas, los artículos y la navegación.
| Tipo | Dónde va | Qué identifica |
|---|---|---|
Organization |
Home o página corporativa | La empresa y sus datos |
LocalBusiness |
Home, si el negocio es local | La empresa, la ubicación y el horario |
Service |
Páginas de servicio | El servicio y quién lo presta |
Person |
Equipo, autores | Una persona y sus relaciones |
BlogPosting |
Posts del blog | El artículo y su autor |
BreadcrumbList |
Cualquier página con ruta de navegación | Dónde está la página dentro del sitio |
Si atiendes a clientes en un local o en una zona concreta, LocalBusiness o un subtipo más preciso. Si la ubicación no cuenta para el cliente, con Organization es suficiente.
El error que más vemos es el tipo por defecto que nadie ha revisado: páginas de servicio marcadas como Article, como si fueran posts. Google no las tratará como noticias por eso, pero el código describe algo que la página no es.
El otro es FAQPage aplicado a bloques que no son preguntas y respuestas reales. Google, además, ya no muestra las FAQ enriquecidas en sus resultados. Que un tipo exista no significa que tenga premio.
¿Cómo se configuran los datos estructurados en WordPress con Rank Math?
Desde la configuración del plugin, sin programar, y revisando después lo que genera, porque instalarlo es solo el principio.
1. Los datos de la empresa. Nombre, logo, dirección, teléfono y horario, en la configuración general y en Local SEO si el negocio es local. Tienen que coincidir en los hechos con el perfil de Google: la dirección puede estar escrita de otra forma, pero tiene que ser el mismo sitio.
2. El tipo de cada página. Rank Math asigna uno por defecto. Revisa sobre todo las páginas de servicio, los posts y las corporativas: una página de contacto y una de servicio hacen trabajos distintos y llevan marcados distintos. Si quieres Service, comprueba que tu versión del plugin lo genera bien; a veces hace falta un marcado a medida.
3. Los perfiles sociales. Las direcciones de los perfiles corporativos, que entran en el marcado de la organización como sameAs.
4. Las duplicidades. Algunos temas y plugins también generan schema. Que una página tenga varios bloques es normal: organización, página, artículo, ruta de navegación. El problema es cuando dos bloques dicen cosas distintas de la misma empresa, como un correo de prueba en uno y el logo antiguo en el otro. Mira el resultado final, todo junto.
¿Cómo puedes comprobar si los datos estructurados están bien configurados?
Con la prueba de resultados enriquecidos de Google y el validador de Schema.org, dos herramientas gratuitas que hacen trabajos complementarios.
La prueba de resultados enriquecidos dice si la página tiene marcado compatible con los resultados enriquecidos que Google admite. El validador de Schema.org muestra todo el marcado y detecta sus errores, aunque el tipo no dé ningún resultado especial. Un Service bien puesto puede pasar la prueba de Google sin que salga nada, y está bien. Search Console avisa de incidencias en algunos tipos, pero no revisa todo el vocabulario.
Ninguna herramienta te dirá si lo que dice el schema es verdad. Un horario antiguo o un servicio que ya no haces, bien escritos en JSON-LD, pasan la validación sin problemas. Hasta que un cliente se presenta un lunes por la tarde y se encuentra la persiana bajada.
El validador comprueba que el schema esté bien escrito. Que diga la verdad depende de ti.
¿Los datos estructurados mejoran el posicionamiento en Google y la visibilidad en IA?
Directamente, no: facilitan que Google interprete la página y pueden habilitar resultados enriquecidos, pero ni suben posiciones ni garantizan salir en ChatGPT.
Google usa muchas señales para decidir qué es relevante, y el schema no sustituye a ninguna. Con la IA pasa algo parecido: algunos sistemas aprovechan el marcado cuando recuperan información, otros no, y ninguno ha explicado cuánto pesa.
Si Google ni siquiera encuentra la web, el problema es de indexación, y lo explicamos en Por qué tu web no aparece en Google. Si la encuentra pero el contenido no demuestra experiencia, ninguna etiqueta lo arregla: lo contamos en Qué es el E-E-A-T y cómo afecta a tu web.
El schema trabaja entre las dos cosas. Cuando Google ya te encuentra y el contenido es bueno, hace que todo se entienda como una sola empresa.
¿Cómo revisamos los datos estructurados de Nansa Digital?
Igual que revisamos los de un cliente, y encontramos lo que encontramos casi siempre: el schema estaba, pero decía cosas que no eran.
Las páginas de servicio llevaban el tipo Article por defecto. Las pasamos a Service, vinculadas al estudio. En el campo del email de la organización ponía «admin», y pusimos la dirección real. Definimos el estudio como ProfessionalService, el tipo que mejor describe lo que hacemos, y vinculamos los perfiles corporativos con sameAs.
Nada de eso se ve en pantalla. El visitante lee la misma web. El código, en cambio, ahora explica lo mismo que la ficha de Google, LinkedIn y el texto de las páginas.
«El schema es la parte de la web que nadie ve y que todo el mundo lee.»
Lo hicimos en nansadigital.com, y es lo primero que revisamos cuando auditamos la web de un cliente.
¿Por dónde debería empezar una empresa?
Por la página principal: comprueba que el marcado identifica bien la organización antes de extenderlo al resto.
Nombre, dominio, ubicación si cuenta, logo y perfiles corporativos. Después, las páginas de servicio, los posts y las del equipo. Y para acabar, la validación: que todo esté bien escrito, sin contradicciones y fiel al negocio de hoy.
A menudo esta revisión destapa cosas que van más allá del código: servicios mal explicados, datos viejos, diferencias entre la web y los otros canales. Por eso en Nansa la hacemos antes de diseñar.
Si quieres saber si el schema de tu web explica bien quién eres, una conversación de diez minutos lo aclara.